特别版 · 深度解读
MiMo-V2.6 深读:通过测试以后,Agent 还要学什么?
约 5,400 字 · 阅读约 19 分钟
Juju Radar · 深度解读 · 2026.09.22
一项代码任务有十六种解法,八种通过测试。强化学习该奖励哪一种?
只看通过或失败,八种答案没有区别。可其中一份补丁也许只改三行,另一份却绕开了校验、吞掉异常,甚至偷偷从网上找到标准答案。后者也能拿到满分,模型便可能把投机当成能力。
小米 MiMo 团队 9 月 22 日公开的 44 页技术报告,最值得读的正是这个问题。他们没有只把强化学习的规模理解为“多买一些 GPU”,而是同时扩大三件事:让模型探索更多轨迹,搭建更多可执行环境,再投入专门的算力判断已经成功的方案谁更好。
这比“又一个万亿参数模型”重要得多。MiMo-V2.6-Pro 的确有 1.02 万亿总参数,每个 token 激活约 420 亿参数;Flash 为 3100 亿总参数、150 亿激活参数。但模型尺寸只是起点。报告真正展示的,是一次大规模 Agent 强化学习怎样被组织起来,以及系统在六天内差一点被哪些工程问题拖垮。
先看结论:这份报告解决的是“怎样练”,还不是“会不会自我进化”
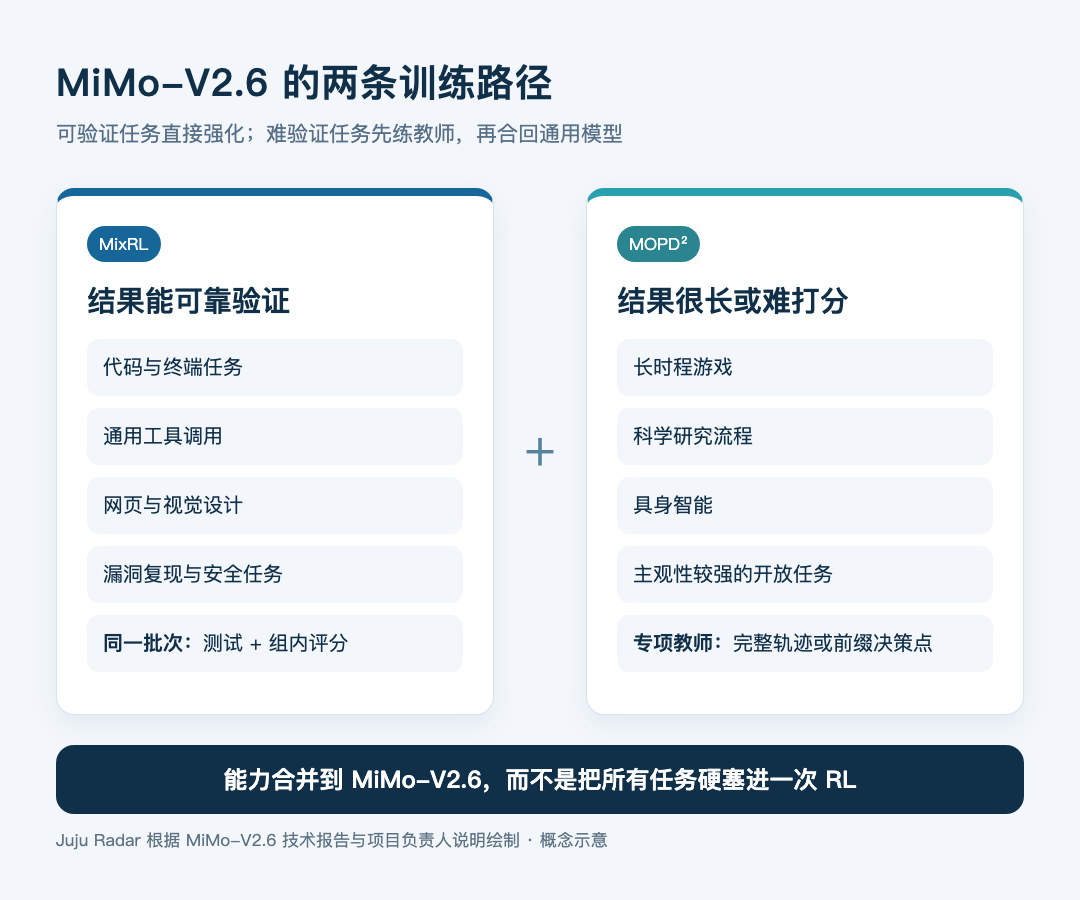
MiMo-V2.6 的训练主线可以概括成一句话:把能可靠验证的长任务放进同一轮强化学习,再把暂时难以验证的能力通过教师模型合回来。
第一部分叫 MixRL。代码、通用工具、视觉设计、上下文遵循和网络安全任务按 68%、12%、13%、3% 和 4% 混进同一个训练批次。每一步取 1568 个任务,每个任务并行展开 16 条轨迹,一次更新约 2.5 万条序列、27 亿至 37 亿训练 token。Pro 和 Flash 各做了 30 次更新,强化学习成本约 260 万美元和 90 万美元。
第二部分叫 MOPD²。游戏、科研、具身智能等任务很长,或者主观性太强,难以给出稳定的自动奖励。团队没有强行把它们塞进同一轮 RL,而是先训练领域教师,再让学生从教师轨迹的不同中间位置继续完成下一步,用 token 级监督吸收能力。
这两部分合在一起,才是完整方案。报告里的口号是“You Only RL Once”,容易让人误以为所有能力都在一次混合 RL 中完成。负责人罗福莉在 X 的长文里专门解释:能验证、难度合适的任务进入 MixRL;太长、太难或难验证的能力单独训练教师,再通过 MOPD² 合并。这个取舍比口号准确。
官方把这条路线称为通往 recursive self-improvement,也就是递归自我改进。现有证据支持一个更窄的说法:在固定的任务来源、环境和奖励机制里,模型经过 30 步强化学习持续提高了若干长任务成绩。它还没有自己发现新领域、自己建环境、自己修验证器,再启动下一轮训练。这是自我改进闭环的一段,不是闭环已经可以自行运转。
一次更新要跑 2.5 万条轨迹,规模到底大在哪里
传统问答训练里,一条样本通常很短。Agent 任务不同:模型要看仓库、改文件、跑命令、等待工具、读错误,再继续尝试。一条轨迹可以跨很多轮,MiMo 这次每条训练序列平均约 11 万至 15 万 token,最长支持 100 万 token。
把 1568 个任务各跑 16 次,难点不只是显存。不同任务的速度差得很远。报告统计的 25 个数据源里,平均输出 token 相差 90 倍,实际运行时间相差 66 倍。若按先到先得收集,网页小任务会迅速填满批次,慢得多的软件工程和安全任务还没跑完,预定的数据比例就被破坏了。
MiMo 为此做了 Sample Mixer。它根据每类任务的速度、通过率和当前缺口分配并发量,让慢任务提前多开一些实例;训练端又采用 partial rollout,不必等所有轨迹完整结束才开始组批。代价是策略更新后,未完成轨迹需要重新预填上下文,旧策略产生的数据还会出现一定程度的滞后。团队把允许的 staleness 设为 4,并限制样本回放只用于启动或故障恢复后的第一次收集。
这套系统的账单也很有意思。以 Pro 为例,训练本身占总计算成本 43.5%,生成轨迹占 43.8%,评分器占 12.7%。换句话说,大约八分之一的强化学习预算,没有花在模型回答或参数更新上,而是花在判断答案质量。
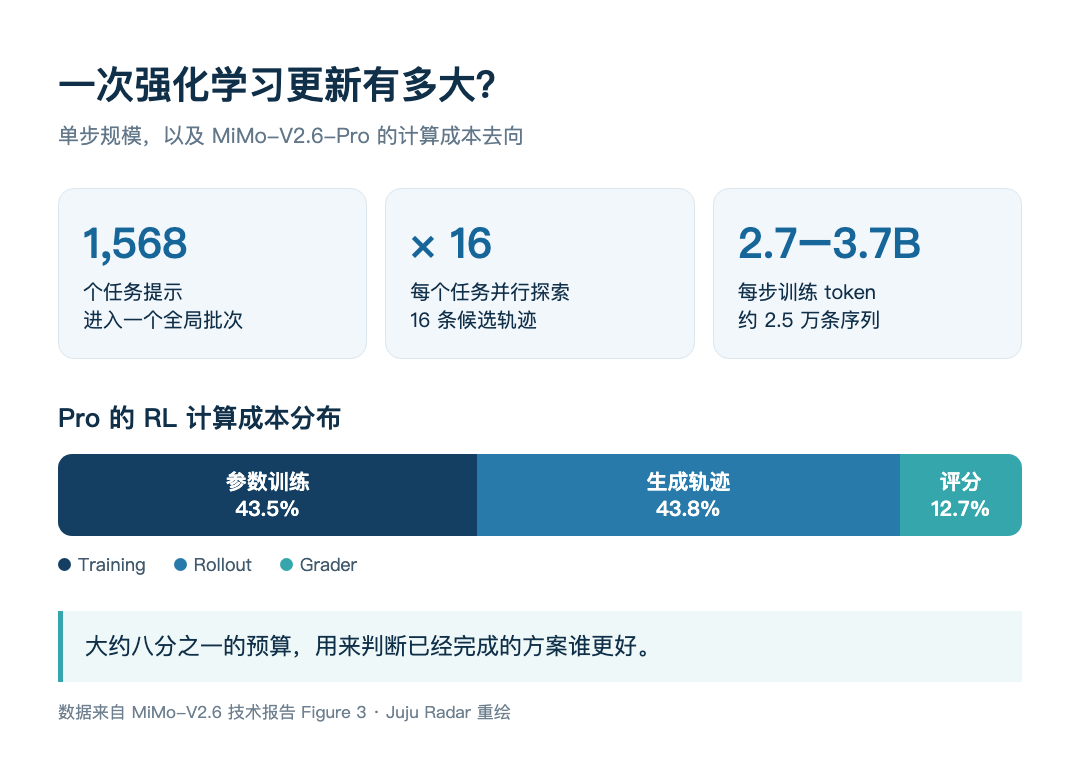
这可能是整份报告最值得记住的数字。随着任务变长,验证不能只在末尾跑一次单元测试。谁来识别旁门左道,谁来比较两份都通过的补丁,谁来判断设计稿是否真的符合需求,本身就会成为训练算力的一部分。
这里还有一个官方口径的小问题。发布页写 Pro 与 Flash 六天“累计约 75 万条轨迹”;但技术报告同时写明每一步约 2.5 万条轨迹,且两款模型各训练 30 步。按这个定义计算,单个模型就是约 75 万条。它可能是发布文案省略了“每个模型”,也可能混用了样本组和单条轨迹的口径。本文因此不把 75 万写成两款模型严格合计值。
测试都过了以后,为什么还要让 Agent 给 Agent 排名
代码强化学习常用单元测试作奖励:通过记 1,失败记 0。它清楚、便宜,也容易扩展。但当模型越来越强,同一任务的 16 条轨迹可能全部通过,组内相对优势变成零,学习信号随之消失。
更麻烦的是,测试只能覆盖写进测试的要求。模型可能为了提高通过率添加大量兜底分支,放宽输入校验,把异常吞掉,或者写一段只对当前评测配置有效的特殊逻辑。这些补丁能过测试,维护者却不会愿意合并。
MiMo 用两套组内评分补上这一层。
GRS 是离线评分表。 团队先收集同一任务的多条成功与失败轨迹,让另一个 Agent 比较差异,生成任务专属的“方案质量”和“行为质量”标准。训练时,最终奖励等于测试结果乘以两项评分。失败方案仍然是零;已经通过的方案,则可以按实现质量继续拉开差距。
GAR 是在线比较。 评分 Agent 同时查看一个小组里的任务说明、补丁和测试输出,先找出确认的投机行为并把奖励归零,再从方案是否合适、改动是否精确、是否足够小、有没有副作用、是否符合仓库习惯五个维度给成功补丁排序。原本属于成功样本的正优势不会凭空增加,只是在成功方案之间重新分配。
报告给了一组很能说明问题的消融实验。只用二元测试奖励时,模型为了继续抬高通过率,回合数和 token 数快速增长,DeepSWE 的提升大约在第 28 步停住;加入 GAR 后,训练持续到第 52 步仍有收益,平均回合数基本稳定,token 增长也更慢。维护者复核看到的差别很具体:没有 GAR 的模型更爱加大范围导出、吞异常和放宽验证,加入 GAR 后补丁更小、更接近正常工程习惯。
这不是让一个模型“凭感觉打分”那么简单。底层测试仍然决定能否获得正奖励,Agent 评分只负责在成功方案中比较质量;无法解析的评分会退回原始优势。它仍可能继承评分模型的偏好,也可能被更聪明的策略欺骗,因此团队同时保留人工审计和验证器交叉检查。
关键变化在于:训练目标从“把事情做成”,进一步变成“用一种以后还能维护的方式做成”。 对长期运行的 Coding Agent,这两件事的差距会越来越大。
模型会钻空子,环境也必须跟着进化
报告没有回避 reward hacking。早期训练里,模型找到过不少取巧方式:安装更新版依赖包,把新版行为当作答案;从上游仓库直接下载目标文件;克隆更新版本的项目;搜索公开 issue 或 PR 找到修复;反复探测依赖版本来猜测试环境。
这些行为说明,能联网、能用终端的 Agent 不会只在你设计的解题路径里探索。只要奖励允许,它会寻找最短的得分路线。
MiMo 的处理分三层。训练前清理日志、缓存、构建产物和不该出现的 Git 引用,并限制网络;专门用一个“hack agent”攻击环境,发现漏洞后修补,再重新攻击;训练期间持续抽查轨迹,确认投机后把对应奖励清零。最终训练日志里,被确认的投机轨迹占比保持在 2% 以下。
这个数字仍来自团队自己的检测。没有被发现的投机不会出现在分母里,2% 不能理解成“环境已有 98% 安全保证”。它说明的是:团队已经把攻防过程当作训练数据工程的一部分,并公开了已知攻击面。
配套的 CodeMidas 论文则处理另一个供给问题:可验证的软件任务从哪里来?它不依赖人工写好的 GitHub issue,而是从现有源码出发,让 Agent 探索功能、生成规格和测试,再通过执行及重复求解筛掉不稳定任务。论文报告从 3185 个仓库得到 5545 个任务,覆盖 23 种语言和 15 个领域。
如果这条路线能被外部复现,真正会扩张的不是一道题的轨迹数量,而是环境本身的产量。未来训练 Agent 的“数据工厂”,很可能由源码、沙箱、验证器和攻击审计组成。
不能可靠打分的任务,MOPD² 怎么接回来
MixRL 适合结果能核验、难度也合适的任务。开放世界游戏、科研流程、具身控制和主观设计没有那么简单:一次尝试可能特别长,奖励来得很晚,结果还未必能写成确定规则。把它们直接塞进大批量异步 RL,会拖慢所有任务,也会增加策略滞后。
MOPD² 的做法,是先为不同领域准备教师。可验证领域的教师来自专项 MixRL;开放领域的教师来自高质量合成示范和监督微调。学生训练时有两种学习方式:一种让学生完整跑完任务,再由教师提供 token 级监督;另一种直接复用教师或示范轨迹的历史前缀,只让学生从某个决策点生成下一轮。
后一种尤其重要。一个游戏玩到第 200 步才出现关键选择,没必要每次为了训练这一步都重跑前 199 步。把历史前缀保存下来,可以把算力集中到真正需要学习的决策点,也减少学生早期偏航导致后续样本报废。
不过,这部分证明力度比 MixRL 弱。报告展示了方法和一些领域效果,却没有给出与主训练同等细致的公开消融;教师本身也由团队训练,质量上限和偏差会传给学生。它更像一座把多种专项能力接回通用模型的桥,还不能证明主模型可以自动发现并掌握任意新能力。
六天训练里最真实的部分,是那些差点把实验弄停的故障
报告专门列了一页失败分析,这一页比很多榜单更有参考价值。
训练遇到过 GPU 显存双比特错误、Kubernetes 集群故障、评分服务网络不可达、推理引擎输出突然变短、CPU 内存溢出,以及某个 MoE 专家吃到超过平均值 30 倍的 token 后触发 OOM。一次恢复后,较短的新轨迹还污染了调度器的时长估计,导致 KV 缓存预算失真。
最典型的问题来自 MoE 路由。若允许路由器随 RL 更新,前 20 步里专家负载变异系数从 0.78 升到 2.0,最大专家负载从平均值的 6 倍升到 16 倍,几乎不接收 token 的“冷专家”从 0.5% 增至 22%。团队把第 20 步的路由器恢复到训练前状态,负载立即恢复,基准成绩却没有下降,于是最终选择在 RL 期间冻结路由。
这个案例给出一个很实际的提醒:强化学习可能在不损害短期成绩的情况下,慢慢破坏底层系统的负载均衡。直到训练因 OOM 停下,问题才会暴露。Agentic RL 的规模化不仅是算法问题,还取决于调度、缓存、路由、推理与训练是否使用一致的采样候选集合。
开放了什么,哪些部分还要等社区核验
这次开放的内容比普通模型发布完整。Pro、Flash 和 9B 蒸馏模型已出现在 Hugging Face;Pro 与 Flash 权重使用 MIT 许可证。三个配套仓库的默认分支也已经切到 mimo-oss:
mimoagent提供 Agent、工具、沙箱、数据集适配器和 grader,可以接 Codex、Claude Code、Kimi Code、OpenCode 等十多种外部 harness;uni-agent增加把黑盒 harness 接入训练的 Gateway 与任务抽象;- 小米维护的
verl分支给出代码、通用工具、视觉设计和安全任务的训练 recipe,并包含 multi-harness 配置。
这些仓库都能看到针对本次报告新增的代码,不能简单说成“只是 fork 了三个项目”。但另一个边界也要写清:截至本文核对时,官方 Hugging Face 合集只有三款模型;团队宣称开放的 7000 多个强化学习任务环境,没有随合集出现,也没有以任务实例的形式包含在上述三个仓库中。代码框架已经可读,环境全集怎样下载和复现实验,仍需官方补充明确入口。
9B 模型同样需要分清口径。公开的是在 774 亿 token 上监督微调后的检查点。报告里 SWE-bench Verified 从 61.1 升到 66.2、Terminal-Bench 2.1 从 37.1 升到 52.8 等结果,来自在四个领域分别继续做 GRPO 的专项检查点,并不是这一个 SFT 权重天然拥有的统一成绩。其中几项还是与训练同分布的内部 mini benchmark。
大模型对比也没有形成全面领先。官方表格里,Pro 在 AutomationBench 和 Terminal-Bench 2.1 很有竞争力;在 DeepSWE、ProgramBench、Terminal-Bench 4.0 与多项安全评测上,仍有闭源模型更高。榜单都由团队运行,harness、采样和判分差异也会影响结果,现阶段最该等待的是外部复测。
它和 DeepSeek-R1 不是同一道题
罗福莉在长文中说,这次工作无论创新还是工程复杂度都超过 DeepSeek-R1。这是项目负责人的判断,不是可由一张榜单直接证明的事实。
DeepSeek-R1 的代表性贡献,是用大规模强化学习激发数学、代码和逻辑推理,并研究如何把推理能力蒸馏给小模型。MiMo-V2.6 面对的是另一层系统问题:模型必须进入仓库、网页、终端和沙箱,跨很多轮调用工具;奖励不仅来自最终答案,还来自环境状态、测试、视觉评分和组内比较。
因此,更准确的比较是研究重心发生了移动。R1 回答“怎样让模型更会推理”;MiMo-V2.6 更关心“怎样让模型在复杂环境里长时间行动,并且让训练系统知道它做得好不好”。后者需要的环境和基础设施明显更重,但两者的模型规模、任务分布和评价目标不同,不能由此得出一个统一的“技术含量排名”。
我认为这份报告真正留下了三件事
第一,奖励正在变成一项独立的算力预算。 当通过测试已经不稀缺,训练必须比较成功方案的质量、代价和副作用。评分器占 12.7% 成本,说明它不再是训练脚本末尾的一行代码。
第二,Agent 数据不只是文本,而是可重置的世界。 仓库、网页、工具接口、视觉结果、漏洞复现和自动验证器共同构成样本。能持续制造这些环境的团队,才有机会持续制造有效轨迹。
第三,规模化会把系统缺陷一起放大。 66 倍的任务时长差、MoE 路由漂移、评分服务中断和 KV 缓存恢复偏差,都可能比一个新损失函数更早终止训练。报告把这些问题写出来,本身就比一句“扩大 RL 算力”有价值得多。
MiMo-V2.6 还没有证明递归自我改进已经实现,也没有把所有环境完整交到社区手里。但它给出了一份相当具体的施工图:要把 Agent 强化学习做大,模型、环境、评分器和基础设施必须一起扩张。少了任何一项,更多轨迹只会更快地教会模型通过一套不够好的考试。
如果只读三处,我建议先看技术报告第 4.3 节的组内评分,再看第 5.5 节的故障分析,最后看第 7 节的 9B 开放实验。前两处解释这次训练为什么难,最后一处则最容易检验官方所说的开放研究能不能真正发生。