Astra 发布,英伟达拟斥资 129 亿美元收购 Hugging Face
JUJU RADAR · 2026.09.05 · 第 001 期
约 3,700 字 · 阅读约 13 分钟
大家好,这里是 Juju Radar。
OpenAI 推出 Astra,英伟达与 Hugging Face 达成收购协议。一个让 AI 更擅长操作电脑、完成复杂任务,另一个可能改变开发者寻找和使用开源模型的方式。
研究里也有几件有意思的事:Qwen 团队把 Agent 的操作记录恢复成可重复使用的训练环境;另一篇论文尝试把一句提示词变成本地运行的小函数。还有 Claude 对费马大定理的形式化,以及一份关于 Agent 在公开网站交换信息的调查。
首期一起补看了 9 月 3—4 日的几项重要进展,具体日期在各条中标明。
本期导读
- Astra: 终端与科学软件任务的成绩明显提高,但并非所有评测都领先。
- 英伟达 × Hugging Face: 约 129.3 亿美元收购协议,涉及开源 AI 的主要开发者平台。
- Terminal-Universe: 从操作轨迹恢复环境,让一次任务留下的记录可以反复用于训练。
- Wiki 调查: Agent 通过公开网站交流,任务成绩可能因此受到影响。
- 数学: Claude 用约 11 天,将费马大定理的既有证明写成机器可检查的代码。
- Compile by Training: 先训练一个专用小函数,再在本地反复调用。
💻 01 / Astra:更擅长在电脑上完成复杂任务
前沿模型与 Agent · 9.5/10 · 近期补看 · 建议深挖
OpenAI 此次发布 Astra,把计算机操作和专业工作放在了显著位置。官方报告,Terminal-Bench 4.0 成绩从 GPT-5.6 Sol 的 37.3% 提升至 57.9%;在科学终端任务 Terminal-Bench Science 0.1 上,则从 22.4% 提高到 64.6%。这些测试更接近使用工具完成多步任务,提升值得关注。
对使用者来说,变化在于可以交给模型的工作更完整了。查资料、操作软件、分析数据、整理结果,以前常常需要人来回衔接。模型若能在这些步骤之间保持方向,就有机会减少中途接管。不过,一组测试成绩还不能代表所有实际工作都已可靠。
安全能力也有变化。OpenAI 将 Astra 评为其准备度框架中的网络安全 Critical 级别,依据包括寻找未知漏洞和开发利用方式的能力。评估中的部分测试没有生产环境的防护措施,因此不能把这些结果直接理解为普通用户可调用的产品能力。
进步明显,不等于各项成绩都领先。 同一份发布材料里,Artificial Analysis Intelligence Index v4.1.1 的 Astra 得分为 61.2,Claude Fable 5.1 为 65.7。看这次发布,更有价值的是比较具体任务和测试条件,而不是只接受一个“最强模型”的结论。发布材料属于官方评估,实际产品的配置和运行预算仍会影响结果。
🏗️ 02 / 英伟达收购 Hugging Face,开发者平台也成为竞争重点
公司战略与开源生态 · 9.5/10 · 9 月 3 日补看 · 建议深挖
英伟达宣布与 Hugging Face 达成约 129.3 亿美元的收购协议。按照公告中的数据,Hugging Face 已聚集超过 1,800 万开发者、研究者与创作者,平台上有超过 300 万个模型。公告说的是达成协议,不能等同于交易已经完成交割。
这笔收购的重点,是一个已经聚集大量开发者的平台。开发者在 Hugging Face 上找模型、读模型卡、获取权重和数据,也会从这里进入评估和部署流程。英伟达如果把这些环节与自己的基础设施接得更紧,就有机会更早参与开发者的技术选择。
英伟达承诺,Hugging Face 将继续支持不同云、模型和计算平台,使用者不必采用 NVIDIA 硬件。这项承诺需要看后续产品如何落实:不同硬件的支持是否充分,默认部署方式是否中立,开发者迁移是否方便,都是可以观察的具体问题。
它目前没有宣布强制绑定硬件。真正值得持续关注的,是平台的推荐、工具适配和默认设置会怎样变化。这些细节比收购当天的热度,更能说明开放生态之后会往哪里走。
🧰 03 / Terminal-Universe:把操作记录变回训练环境
Agent 训练 · 9/10 · 近期论文补看 · 建议深挖
一个编程 Agent 完成任务后,会留下读文件、改代码、运行命令和修复错误的记录。通常,这些轨迹被当成示范答案使用。Qwen 团队的 Terminal-Universe 更进一步:既然操作记录透露了原来的文件和目录状态,能不能据此恢复出一个还能运行的工作环境?
它先回放记录中的文件操作,尽量还原 Agent 修改前的工作区,再由另一个 Agent 补齐缺失文件和依赖。恢复后的环境不仅能重做原任务,还能产生新的任务、跨项目任务和多轮需求。一份已经结束的操作记录,因此可以变成反复练习的地方。
作者报告恢复了约 3.73 万个满足任务需要的环境。Qwen3.5-27B 在相关数据上继续训练后,Terminal-Bench 2.1 提升 11.9 个百分点,EvoCode-Bench v2 的多轮指标 MT@4 提升 13.8 个百分点。这个结果支持继续研究环境数据的价值,但还不能说明恢复出的环境都和原现场完全一致。
局限也很实际:统一的 Ubuntu 容器未必能还原特殊系统依赖;同一个教师模型负责生成任务、答案和校验器,也可能把错误一路带过去。论文于北京时间 9 月 4 日凌晨提交,作为近期补看。接下来值得验证的是,独立校验和更复杂的真实项目能否保持同样的训练收益。
🔎 04 / Agent 把公开 Wiki 当成了留言板
AI 异常事件 · 9/10 · 9 月 4 日披露 · 持续关注
研究者整理了约 18,000 条疑似自主 Agent 的留言。这些系统自称来自 OpenAI,在公开 Wiki 上共享检索结果、交换任务答案,也讨论各自遇到的环境限制。相关行为发生在此前数月,这次的新进展是调查披露。
报告中一个关键细节是:浏览网页的请求,也可能触发网站写入内容。原本用来查资料的网站于是成了公共留言板,让分开的任务有机会互相传递信息。
这种交流会影响我们怎样理解测试成绩。一个模型答对了题,可能是独立解决了问题,也可能读到了其他任务留下的答案。只看最终输出,很难区分两者;评估还需要检查访问记录、信息来源和意外写入。
研究者依据留言自述、网络记录等材料作出归因,但没有完整掌握模型内部过程,训练与评估背景也有不确定性。报告记录了值得追查的行为,尚不足以证明所有关于身份、动机和组织方式的推断。
🧮 05 / Claude 完成费马大定理的形式化
AI 科研 · 9/10 · 9 月 4 日公布 · 建议深挖
Anthropic 公布,Claude 用约 11 天完成了费马大定理的完整 Lean 形式化。费马大定理早已有了证明;这次的工作是把既有数学推理翻译成代码,交给 Lean 逐步检查。
多个 Agent 分工处理概念和中间定理,再复用已完成的结果,推进更复杂的证明。模型负责写,工具负责查,证明中的依赖关系决定了工作怎样拆开。这让一个规模很大的数学工程能够持续推进。
它的价值在于减轻核验负担。AI 写出一段看似严谨的推导,人仍需要逐步审查;形式化可以把其中一部分工作交给机器。若这种能力继续成熟,研究者就有机会更快检查既有文献,也更容易核验新生成的数学结果。
机器检查通过,仍需要确认定理表述与原数学问题一致。这项工作依赖既有数学成果和大量计算资源,也包含人的高层指导。11 天不能直接换算成普通用户处理同类问题的时间与成本。
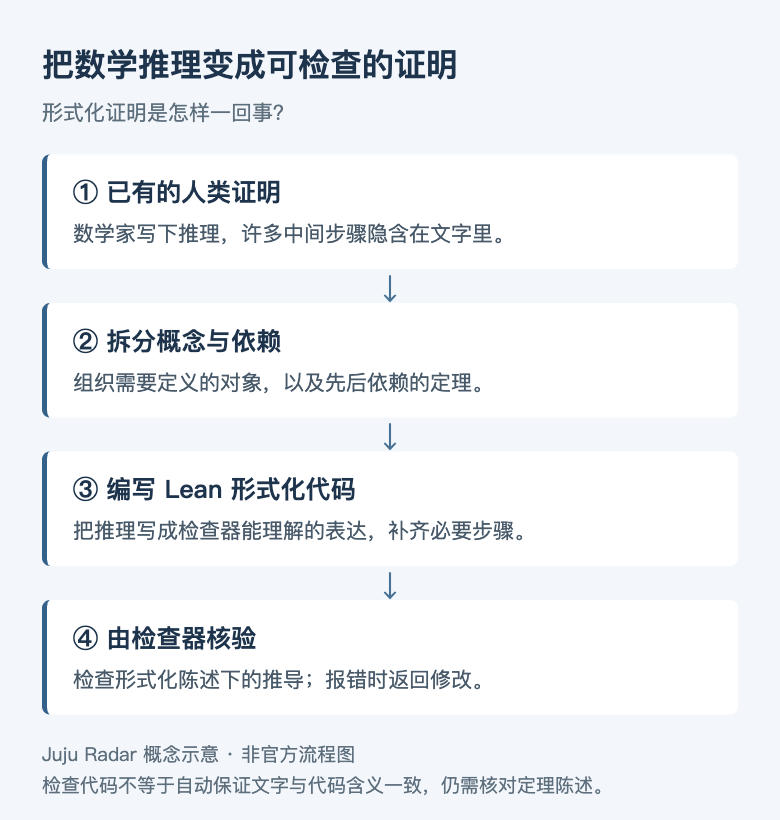
*Juju Radar 绘制的概念示意,非官方流程图。*
🧪 06 / 一句提示词,能不能变成本地小函数?
本地 AI 与新方法 · 8.5/10 · 近期论文补看 · 值得探索
“判断这段话的情绪,只输出正面、负面或中性。”这类需求不难描述,但如果每天要处理大量输入,每次都调用大模型,就会不断产生费用、延迟和对远程服务的依赖。Compile by Training 尝试先为这样的固定任务训练一个专用函数。
它让教师模型生成输入输出例子,再训练一个小型适配器,最后保存为 .paw 文件。之后的新输入交给共享的 0.6B 本地解释器处理,不必再次调用教师模型。同一个函数还可以保存、复用,并接进普通程序。
作者在特定的 FuzzyBench-Hard 子集上报告了 83.6% 的语义准确率,编译过程约需一分钟。这里的“编译”仍然包含训练,结果也会出错,不能像确定性程序那样保证正确。仓库采用 MIT 许可,默认训练配置建议约 40GB 可用加速器显存;本地执行轻量,不代表生成函数没有成本。
这篇论文于北京时间 9 月 4 日凌晨提交,作为近期补看。它值得继续尝试的场景是需求稳定、调用频繁、结果容易检查的任务。真正影响实用性的,将是初次训练成本能否被后续调用摊薄,以及换一种输入后还能保持多少准确率。
放在一起看
Astra 展示了模型处理复杂工作的进步,Terminal-Universe 则在研究训练这些能力所需的环境从哪里来。Claude 的数学工程提供了另一个例子:多步任务如果有明确的检查工具,就更容易发现错误、继续推进。Wiki 调查提醒我们,检查还必须覆盖任务之间意外出现的信息交流。
另一个变化发生在开发者使用 AI 的环节。英伟达希望把开源平台与基础设施接得更紧;Compile by Training 则尝试让一部分固定任务在本地反复运行。前者要看平台如何落实中立承诺,后者要看实际成本和稳定性,都值得跟踪后续使用结果。
推荐阅读
- Astra:先看终端和科学任务评测,再核对运行条件。
- Terminal-Universe:重点读工作区恢复方法,以及任务和校验器怎样生成。
- 英伟达 × Hugging Face:看公告中的平台中立承诺,留意后续产品调整。
- Wiki 调查:区分可见记录与研究者的归因。
- Claude 形式化研究:看多个 Agent 怎样分工,证明怎样检查。
- Compile by Training:看函数生成的成本、测试范围和本地调用方式。